DIE QUELLE
PDF-Eingang
→Rechnungen, Verträge, Exposés, Berichte, Scans — jedes PDF bis 32 MB und 100 Seiten. Reinziehen oder per API einspielen; den Rest macht die Engine.
PDF reinziehen. Eine Pipeline mit vier Prüfläufen liefert sauberes JSON mit Konfidenzwert an jedem Feld — ~90 % Genauigkeit selbst bei den chaotischsten Formaten.
Jedes Team hat denselben Stapel. Rechnungen, die abgelegt werden müssen. Verträge, die die entscheidenden Klauseln verstecken. Immobilien-Exposés, in denen die eine Zahl, die du brauchst, auf Seite 47 steht. Behördenformulare, Schadensmeldungen, Lieferanten-Scans — alles voller Daten, die dein Stack zum Laufen braucht. Und alles steckt in einem PDF, das niemand in Ruhe lesen kann, geschweige denn in ein System abtippen. Also tippt Ops ab. Der Vertrieb tippt ab. Die Finanzabteilung tippt ab. Drei Teams zahlen für dieselbe verlustbehaftete Übersetzung.
Jedes PDF war ein Datengefängnis.
Ein einzelner LLM-Aufruf auf ein PDF halluziniert ungefähr in einem Drittel der Fälle. OCR von der Stange verliert das Layout. Document-AI-Anbieter liefern Konfidenzwerte, aber keine Korrekturen. Keins davon ist gut genug, um das Ergebnis direkt in dein CRM oder deine Buchhaltung zu schreiben.
Der Wechsel ist die Pipeline. Einmal extrahieren. Dann das Dokument erneut lesen und jedes Feld gegen die Quelle prüfen. Dann ein Korrekturlauf, der erfundene Felder entfernt und die markierten repariert. Dann ein programmatischer Rechenlauf, der Summen findet, die nicht aufgehen. Dasselbe Modell, das auch der Einzelaufruf nutzen würde, viermal unter strukturiertem Druck — und die Genauigkeit steigt bei gleichem Input von ~65 % auf ~90 %.
Das Layout übernimmt ein eigenes OCR-Modell. Die Prüfung übernimmt das LLM. Das Schema erzwingt Tool-Calling. Du bekommst sauberes JSON, jedes Feld mit Quelle bis zur Seite, von der es stammt.
Adaptive Extraktion heißt: Die Engine erkennt zuerst, was sie vor sich hat, und wendet dann das passende Schema an. Ein Stack, jeder Dokumenttyp — auch gescannte, mehrsprachige und alte Dokumente.
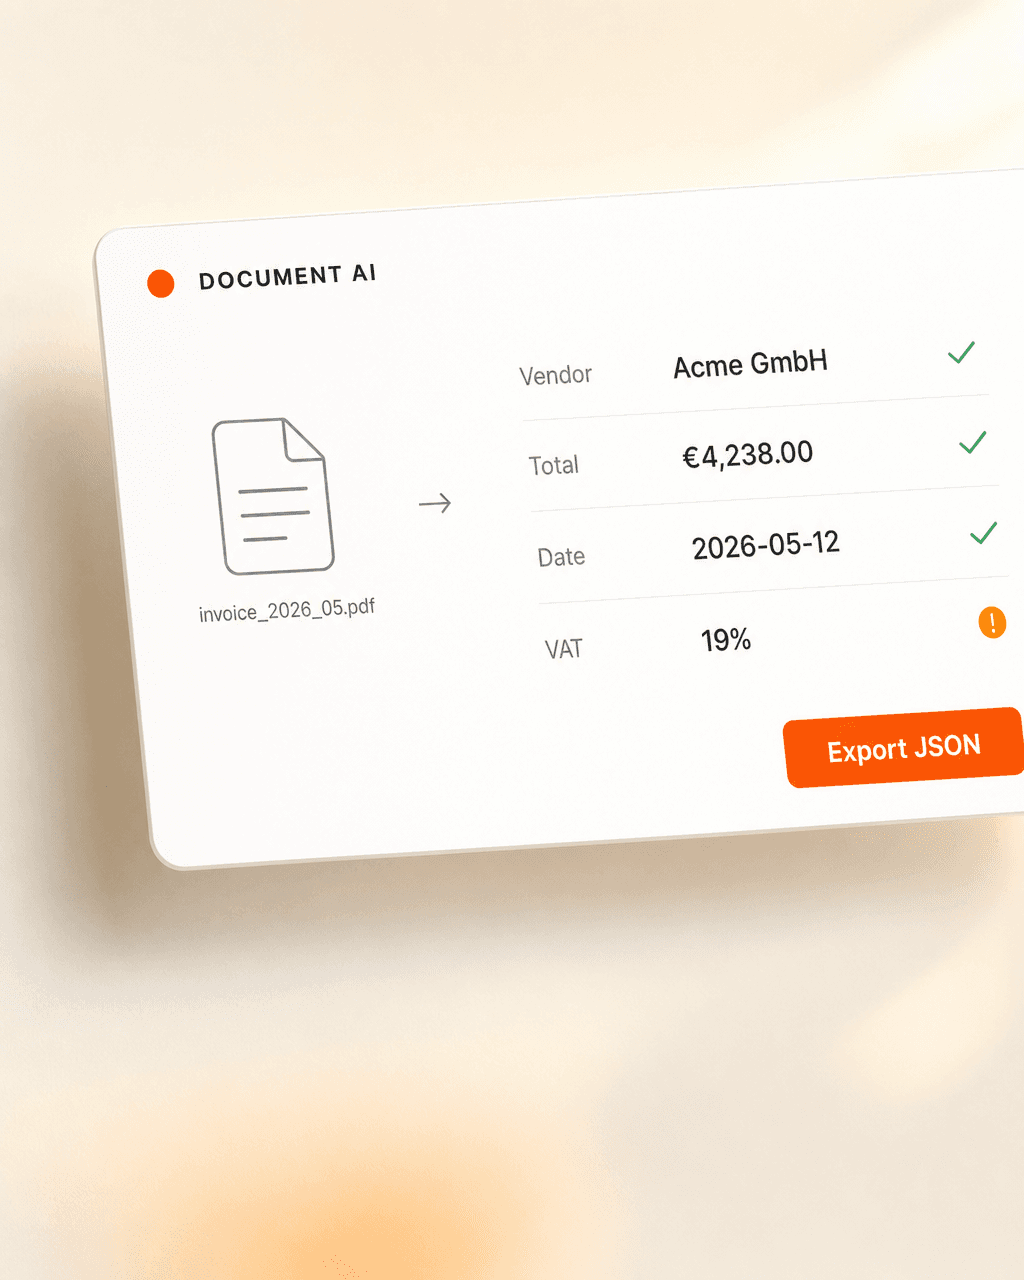
Lauf eins extrahiert jedes Feld mit Quellenangabe. Lauf zwei liest das Dokument erneut und prüft jedes Feld. Lauf drei korrigiert, was die Prüfung markiert hat, und wirft Erfundenes raus. Lauf vier rechnet nach — Summen, Verhältnisse, Daten, die nicht passen. Was in deinem Stack landet, wurde viermal bestätigt.
“Von einem Agent geprüft.das ist das ganze Produkt
Tabellen, CRM, Buchhaltung, Data Warehouse, Webhook — du wählst das Ziel, und die Engine schreibt die strukturierten Daten dorthin, wo du ohnehin arbeitest. Jedes Feld trägt seinen Konfidenzwert; du legst die Schwelle fest, ab der automatisch übernommen oder geprüft wird.
Rechnungen, Verträge, Exposés, Berichte, Scans — jedes PDF bis 32 MB und 100 Seiten. Reinziehen oder per API einspielen; den Rest macht die Engine.
Extrahierte Felder landen als saubere Zeilen in Google Sheets oder Excel — ein Dokument pro Zeile, Spalten nach deinem Schema.
Neue Leads, Objekte, Lieferanten — direkt in deinem CRM angelegt oder angereichert, jedes Feld mit Quelle bis zur Originalseite.
Rechnungspositionen, Umsatzsteueraufteilung, Fälligkeiten, Lieferant — als Buchungsentwurf in sevDesk, Xero oder QuickBooks, bereit zur Prüfung.
Bei großen Mengen fließt das geprüfte JSON direkt in dein Data Warehouse — Postgres, BigQuery, eigenes Schema. Konfidenzwerte inklusive.
Die strukturierten Daten per POST an jeden Endpunkt — deine App, n8n, Zapier, einen internen Service. Jeder Payload enthält Konfidenz und Quelle.
Wähl ein Ziel. Oder zwei. Die Engine schreibt dorthin, wo dein Team schon arbeitet.
Die halbe Woche, die Finanzen und Ops mit dem Abtippen von PDFs verbracht haben, gehört wieder ihnen. Neue Dokumente kommen strukturiert an, mit Quelle, bereit für den nächsten Schritt. Das Team prüft Sonderfälle, statt Positionen abzutippen. Und die Deals, Leads und Objekte, die in ungelesenen PDFs lagen, sind plötzlich durchsuchbar, im Dashboard, mit Alerts — genau das, wofür du die Daten ohnehin bezahlt hast.
Wir definieren das JSON-Schema gemeinsam — die Felder, die du wirklich brauchst, die Prüfregeln, die Konfidenzschwelle für automatische Übernahme. Die Engine arbeitet mit deinem Schema, nicht mit einem generischen.
Wir schicken deinen PDF-Bestand durch die Pipeline, schärfen die Prompts an deinen schwierigsten Dokumenten und binden das erste Ziel an — Tabelle, CRM, Buchhaltung oder Data Warehouse.
Neue PDFs kommen per Inbox, Upload oder API. Die Pipeline läuft. Geprüfte Daten landen in deinem Stack. Wir sind da, wenn du ein neues Ziel anbinden oder das Schema schärfen willst.
Zwanzig Minuten. Bring ein Beispiel-PDF mit — wir gehen das Schema durch, die Prüfläufe und wo das JSON landen soll.
Oder per E-Mail an matthias@lifeisapitch.io